Görüntü Modelleri Neden Latent Uzayda Çalışır
Önceki yazılarda bir model gürültüyü, her seferinde bir tahminle bir görüntüye dönüştürdü. Atladığımız bir sorun var. 512 × 512 renkli bir görüntü 786.432 sayıdır ve model her adımda bunların hepsi için bir tahmin yapmak zorundadır. Stable Diffusion bunun bir yolunu buldu: Piksellerle hiç çalışmaz, görüntünün latent denen çok daha küçük bir hali üzerinde çalışır.
Bu küçük hali ayrı bir model üretir. Onun ilk yarısı olan encoder, kabaca söylersek, her 8 × 8 piksellik parçayı yalnızca 4 sayıya sıkıştırır. Tek bir latent konumunun neyi kapsadığını görmek için kareyi görüntünün üstünde gezdirin.
Bütün görüntü: 512 × 512 × 3 = 786.432 sayı. Latent'i: 64 × 64 × 4 = 16.384 sayı, yani 48 kat daha az.
Boyutlar, 512 × 512 görüntüler üreten Stable Diffusion 1.5'teki gibi. Her latent konumu çoğunlukla kendi parçasını anlatır, ama encoder çevresine de bakar. Gerçek dört sayı encoder modelinden çıkar; bu model bu sayfada çalışmadığı için uydurma değerler yerine soru işaretleri gösteriyoruz.
Bu 4 sayı, her parça için tek bir renk taşıyan minik bir görüntü değildir. Öğrenilmişlerdir: Eğitim sırasında sıkıştırıcı, görüntü onlardan yeniden kurulabilsin diye her parçayı en iyi hangi 4 sayının anlattığını bulmuştur. Bu, latent'i yeniden piksellere çeviren ikinci yarının, yani decoder'ın işidir. Bu ikiliye autoencoder denir ve diffusion modeli henüz tek bir görüntü görmeden önce eğitilir.
Yani Stable Diffusion bir görüntü üretirken önceki yazılardaki bütün adımlar latent uzayda gerçekleşir: Gürültü latent gürültüsüdür ve her tahmin bir latent tahminidir. Sonucu gördüğünüz piksellere ancak en sonda decoder çevirir. Neden bu kadar uğraş? Bir görüntü boyutu seçin ve karşılaştırın.
Latent 64 × 64 × 4: sayılar 48 kat, karşılaştırılacak çiftler 4.096 kat azalır.
Stable Diffusion 1.5 ve XL'deki gibi her kenarı 8 kat küçük ve konum başına 4 sayı taşıyan bir latent için birebir sayımlar. Gerçek modeller tam boyutta her konumu diğer her konumla karşılaştırmaz; son satır, bunun pikseller için neden imkansız olacağını gösteriyor.
48 kat daha az sayı zaten çok iş kazandırır. Ama daha iyisi var. Önceki yazıdaki attention konumların birbirine bakmasını sağlar ve çiftlerin sayısı konum sayısının karesiyle büyür. Pikseller için bu hızla imkansız hale gelir; bir latent için yalnızca büyüktür. Görüntü üreticilerini sıradan bir ekran kartında çalıştırmayı mümkün kılan da bu farktır.
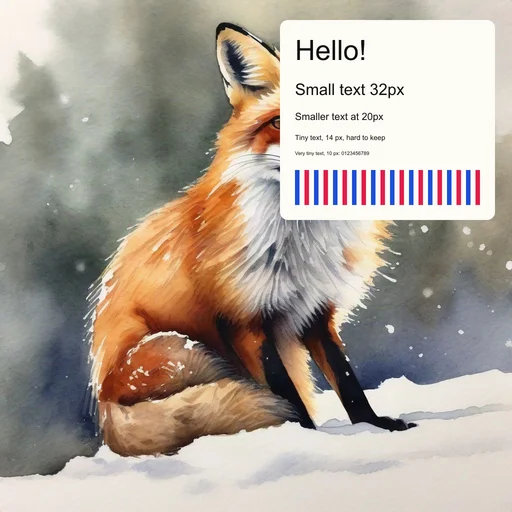
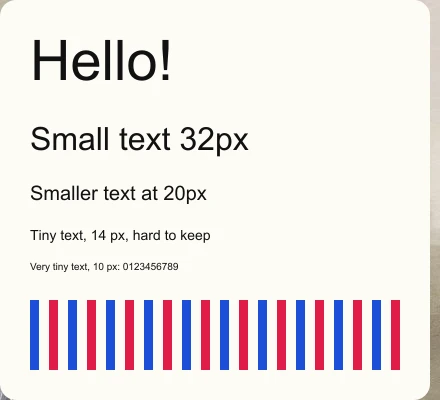
Peki latent minik, bulanık bir görüntüden ibaret değil mi? İşte test: aynı görüntü bir kez 128 × 128 piksellik bir ızgaraya küçültülmüş, bir kez de 128 × 128'lik bir latent'ten geçirilip geri getirilmiş.
 Tam boyutta ayrıntı
İki küçük sürüm de aynı 128 × 128 ızgarayı kullanır: Latent konum başına 4 sayı, küçük görüntü 3 sayı tutar. Latent sürümü, fal.ai'deki Stable Diffusion XL ile servisin izin verdiği en küçük değişiklikle (strength 0.05: çok düşük gürültüde tek bir gürültü giderme adımı) üretildi; yani encoder ve decoder'dan geçen saf bir yolculuğa çok yakın, ama tam olarak öyle değil.
Küçültülmüş görüntü her yerde bulanık. Latent sürümü ise keskin, çünkü decoder gerçek görüntülerin neye benzediğini öğrenmiştir ve 4 sayının işaret ettiği ayrıntıları doldurur. Ama en küçük ayrıntılar bu yolculuktan sağ çıkamaz: En küçük yazı bozuk geri geldi. İlk Stable Diffusion modellerinin küçük yazılarda ve minik yüzlerde kötü olmasının nedenlerinden biri budur. Stable Diffusion 3 ve FLUX gibi yeni modeller daha fazla ayrıntı tutmak için konum başına 4 yerine 16 sayı saklar.
Yani bir görüntü üreticisi aslında birlikte çalışan iki modeldir: görüntüleri küçük ve akıllıca kurulmuş bir uzaya sokup çıkaran bir autoencoder ve bütün işini o uzayın içinde yapan bir diffusion modeli. Bu yönteme latent diffusion denir ve "Stable Diffusion" ailesi bunun üzerine kuruludur.
Bu içerik size yardımcı olduysa bana bir kahve ısmarlayabilirsiniz.

yapay zeka, yazılım ve tasarım üzerine etkileşimli yazı ve kurslardan haberdar olmak için bültene katılabilirsiniz. Ayda en fazla birkaç e-posta alırsınız.
800’den fazla meraklı okura sen de katıl.