Metin Bir Yapay Zeka Görüntüsünü Nasıl Yönlendirir
Önceki yazıda bir model gürültüyü, her seferinde bir tahminle bir görüntüye dönüştürdü. Ama hangi görüntüye? Model kendi başına ancak genel olarak eğitim görüntülerine benzeyen bir şey üretebilir. "Karda kızıl bir tilki" elde etmek için prompt'unuzun her bir tahmine katılması gerekir.
Önce prompt sayılara çevrilir. Text encoder adlı ayrı bir model, kelimeleri anlamlarını taşıyan sayı listelerine çevirir; tıpkı önceki yazıdaki embedding'ler gibi. Görüntü modeli bu sayıları her adımda attention ile okur: Görüntünün her parçası kelimelere bakar ve ihtiyacı olanı alır.
Bir görüntünün tek bir nokta olduğu minik dünyamıza dönelim. Bu kez eğitim görüntülerinin açıklamaları var: Bazı noktalar bir kalp, bazıları bir halka, bazıları da bir yıldız çizer. Prompt'u bilen bir model yalnızca açıklaması uyan eğitim görüntülerini hesaba katmak zorundadır. Bir prompt seçin.
Önceki yazıdaki minik dünya, bu kez açıklamalarla: Eğitim noktaları bir kalp, bir halka ve bir yıldız çizer. Bir prompt verildiğinde en iyi tahmin yalnızca o açıklamaya sahip noktaları kullanır. Birebir hesaplanır; hiçbir şey eğitilmez.
Prompt olmadan noktalar üç şeklin hepsine dağılır. Bir prompt'la her tahmin yalnızca o açıklamaya sahip noktaları karıştırır; böylece aynı gürültü bir kalbe, bir halkaya ya da bir yıldıza dönüşür. Metnin yaptığı tek şey budur: Her adımda tahmini değiştirir.
Gerçek modeller bunu görüntülerden, açıklamalarıyla birlikte öğrenir. Eğitim sırasında açıklama bazen bilerek dışarıda bırakılır; böylece aynı model hiç metin olmadan tahmin etmeyi de öğrenir. Bu çok işe yarar.
Prompt'lu tahminle prompt'suz tahmin arasındaki fark, prompt'un yönünü gösterir. Görüntü üreticileri bu farkı alıp bir sayıyla, yani guidance ölçeği ile çarpar. Bu hileye classifier-free guidance denir. İşte yan yana dört ölçek.
Her panelde aynı 300 gürültü noktası, her biri 30 adım. Bir nokta, ona en yakın eğitim noktası prompt'un açıklamasına sahipse "şeklin üstünde" sayılır; "farklı noktalar" ise şeklin 60 eğitim noktasından kaçına ulaşıldığını sayar.
0'da prompt yok sayılır ve noktalar üç şeklin hepsine dağılır. 1'de model prompt'lu tahminini düpedüz izler ve birebir hesaplanan oyuncak dünyamızda bu zaten yeterlidir. 1'in üstünde noktalar yine doğru şekle düşer, ama gitgide daha az noktaya yığılır: Sonuç prompt'a daha sıkı uyar ve çeşitliliğini kaybeder.
Gerçek modeller tahminlerini kusurlu öğrenir, bu yüzden 1 ölçeğinde prompt'a çoğu zaman gevşekçe uyarlar. İşte Stable Diffusion XL'den gerçek görüntüler: aynı prompt ve her birinin kendi başlangıç gürültüsü olan dört farklı seed. Guidance ölçeğini değiştirin.
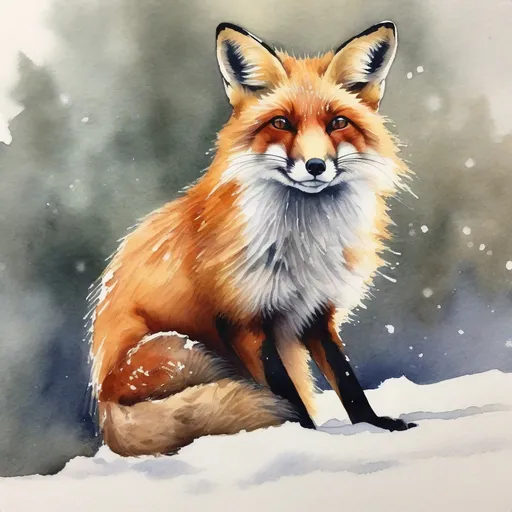 seed 11
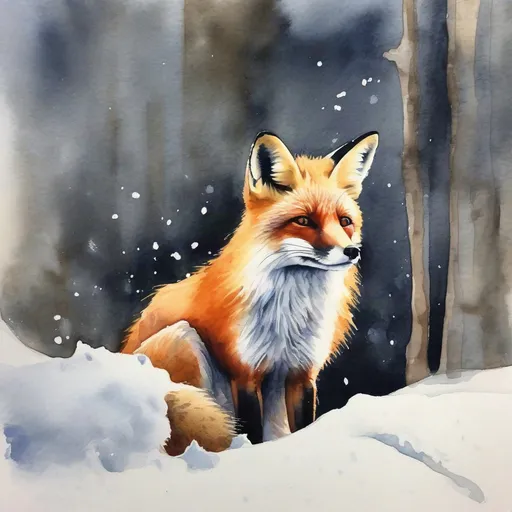 seed 22
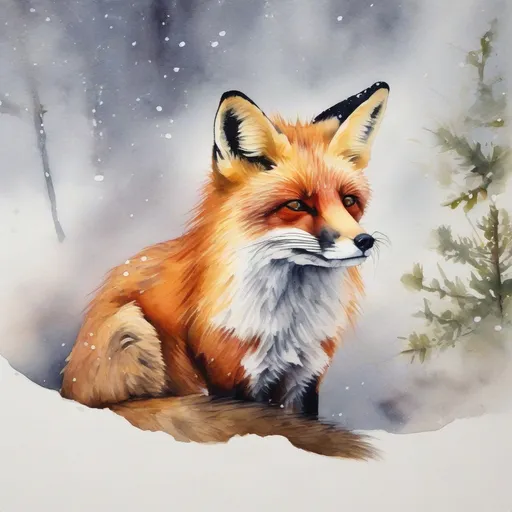 seed 33
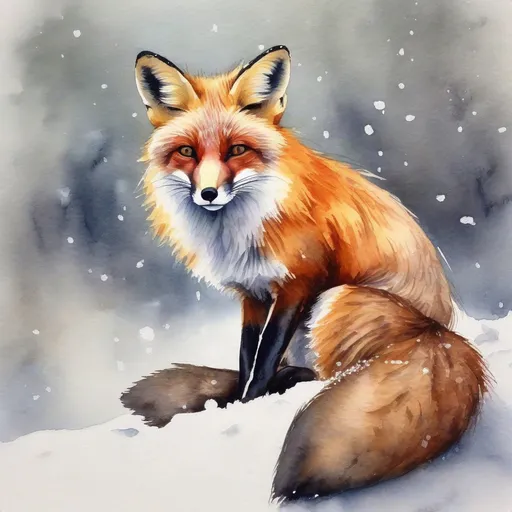 seed 44
Stable Diffusion XL ile (fal.ai'deki fast-sdxl) 25 adımda üretilmiş gerçek görüntüler. Kaydırıcı yalnızca guidance ölçeğini değiştirir; her seed kendi başlangıç gürültüsünü korur.
Noktalardaki örüntünün aynısı. Çok düşükse prompt yarı yarıya yok sayılır. Çok yüksekse görüntüler sertleşir ve birbirine benzemeye başlar. Stable Diffusion gibi araçlarda 5 ile 8 arasındaki değerlerin yaygın bir varsayılan olmasının nedeni budur.
Aynı hile size negatif prompt'ları de verir. Üretici, hiç metin olmayan tahminden başlamak yerine istemediğiniz şeyin tahmininden başlar ve guidance her adımı ondan uzağa iter. Kasede istemediğiniz bir şey seçin.
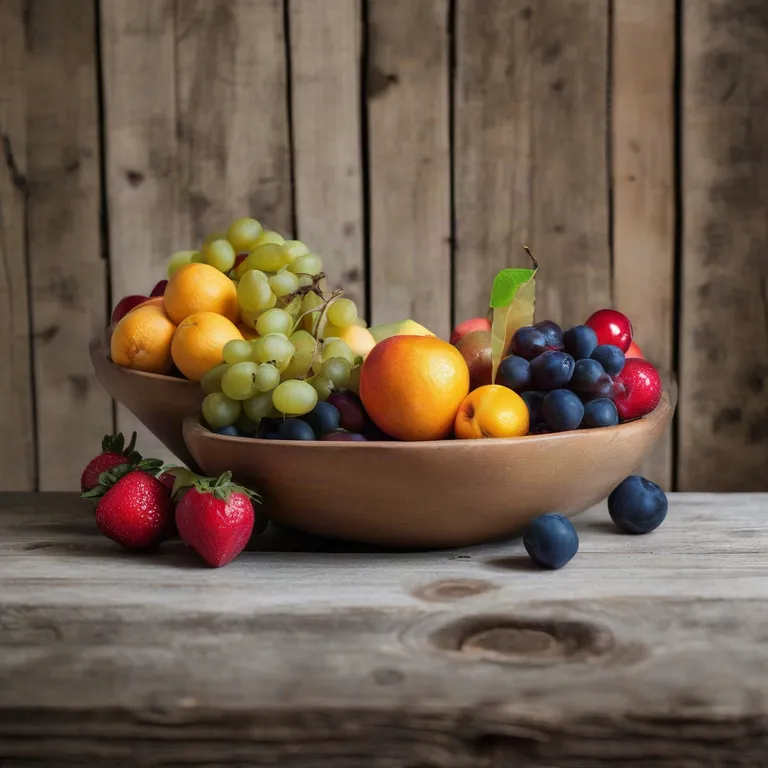
Stable Diffusion XL ile (fal.ai'deki fast-sdxl) üretilmiş gerçek görüntüler: aynı prompt, seed 9, guidance ölçeği 7 ve 25 adım. Yalnızca negatif prompt değişir. Prompt'lar İngilizce, çünkü model çoğunlukla İngilizce açıklamalarla eğitildi.
Değişenin tek bir meyve olmadığına dikkat edin. Negatif prompt yol boyunca her tahmini değiştirir, bu yüzden bütün görüntü biraz kayar. Gerçek bir üreticide prompt ve negatif prompt birlikte çalışır: Her tahmin birine doğru çekilir, diğerinden uzağa itilir.
Yani metin kendi başına hiçbir şey çizmez. Her adımda modelin tahminini değiştirir; guidance ölçeği de bu değişikliğin ne kadar sert iteceğini belirler. Şunu unutmayın: model cümlenizi bir insanın anladığı gibi anlamaz. Açıklamalardan ve görüntülerden öğrendiği kalıpları izler; görüntü üreticilerinin nesneleri saymak ya da onları sola veya sağa yerleştirmek gibi işlerde hala zorlanabilmesinin nedeni budur.
Bu içerik size yardımcı olduysa bana bir kahve ısmarlayabilirsiniz.

yapay zeka, yazılım ve tasarım üzerine etkileşimli yazı ve kurslardan haberdar olmak için bültene katılabilirsiniz. Ayda en fazla birkaç e-posta alırsınız.
800’den fazla meraklı okura sen de katıl.